


软件所在智能化静态代码检查方面取得系列进展
近日,中国科学院软件研究所软件工程技术研究开发中心和基础软件与系统重点实验室的软件质量保障团队取得系列工作进展。相关研究聚焦智能化静态代码检查,围绕代码检查器的自动生成、测试增强与能力评估等方面开展研究,形成了3篇论文成果,分别发表于软件工程领域国际会议ICSE 2026和ASE 2026。
1. Write Your Own Code Checker: An Automated Test-Driven Checker Development Approach with LLMs
作者:刘珺,解远远,燕季薇,黄进豪,严俊,张健
录用会议:ICSE 2026
随着对代码质量保证的需求日益增长,开发人员不仅使用现有的静态代码检查工具,还寻求定制化的检查器以满足特定需求。尽管各类代码检查框架提供了丰富的检查器定制接口,但规则检查逻辑的复杂性以及检查框架中海量的自定义API,使得检查器定制仍极具挑战。因此,自动生成代码检查器被视为减轻检查器人工开发负担的有效途径。
基于以上需求,研究团队提出了一种基于大语言模型(LLM)的新型代码检查器定制生成方法AutoChecker,仅需规则描述和测试套件即可自动编写代码检查器。针对规则逻辑复杂性,AutoChecker模仿人类开发过程对测试用例“逐个击破”,驱动LLM对检查器进行增量式生成与修复,以生成充分检查逻辑。同时,为了增强LLM对于检查框架API知识理解,AutoChecker构建了两个API知识库:Meta-API DB(通用跨框架)和Full-API DB(框架全量),基于逻辑拆解后的检查操作单元进行细粒度API知识检索。
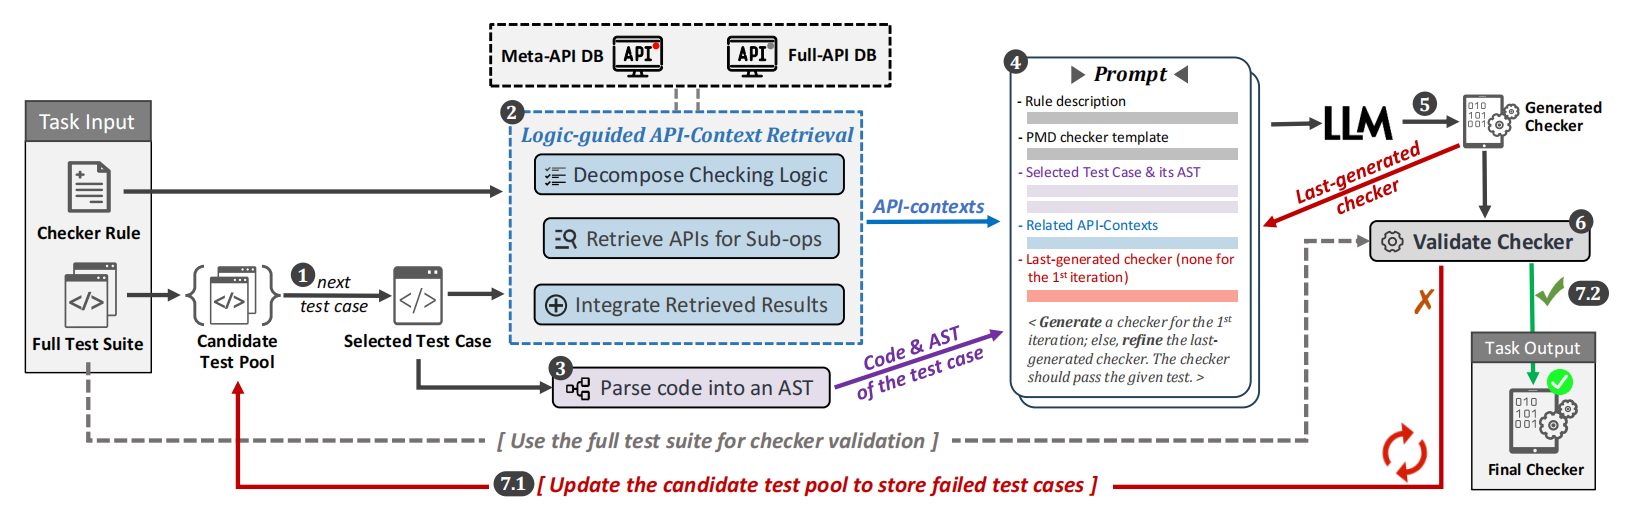
AutoChecker:测试用例驱动的Checker生成方法总览
实验结果表明,由AutoChecker生成的检查器测试通过率高达82.28%,超过了测试中的所有基线和消融方法。当应用于实际项目时,这些自动生成的检查器也表现出与官方检查器相当的效果。
目前,AutoChecker支持ClangTidy、ClangSA、CodeQL、Semgrep、PMD等静态代码检查工具,支持面向C/C++、Java、Python等主流编程语言的检查器定制。由AutoChecker定制生成的检查器在多个流行仓库中扫描出真实缺陷,并获得2个CVE编号。
论文链接:https://dl.acm.org/doi/10.1145/3744916.3764560
在线网站:https://autochecker.veilaxis.com/
工具链接:https://github.com/SQUARE-RG/AutoChecker
2. Every Scenario Matters: Scenario-Guided White-Box Testing for Static Code Checkers Powered by LLMs
作者:刘珺,计理强,燕季薇,潘临杰,任劲松,严俊,张健
录用会议:ASE 2026
在静态代码检查工具中,每条检测规则都对应一个专门的代码检查器。在项目质量保障过程中,很多检查器都面临着误报、漏报等质量问题。因此,对检查器进行全面测试至关重要。现有的检查器测试方法通常是黑盒测试方法,仅基于笼统的规则描述生成测试用例。规则描述往往忽略了实现层面的条件和具体逻辑,导致测试只覆盖部分简单检查场景。
为了弥补这一差距,课题组提出了一种由LLM驱动的场景引导式白盒检查器测试方法ScenSCT。该方法首先将检查器源码转换为统一的基于一阶逻辑的表示形式(CheckerIR),并应用基于逻辑的场景分解和基于规则的场景校验来提取有效的检查场景。随后,它通过“执行反馈引导的测试对齐”为每一个场景生成相应的种子测试用例,并进行“场景不变性测试扩增”,生成能够保持目标场景特征的测试用例变体。
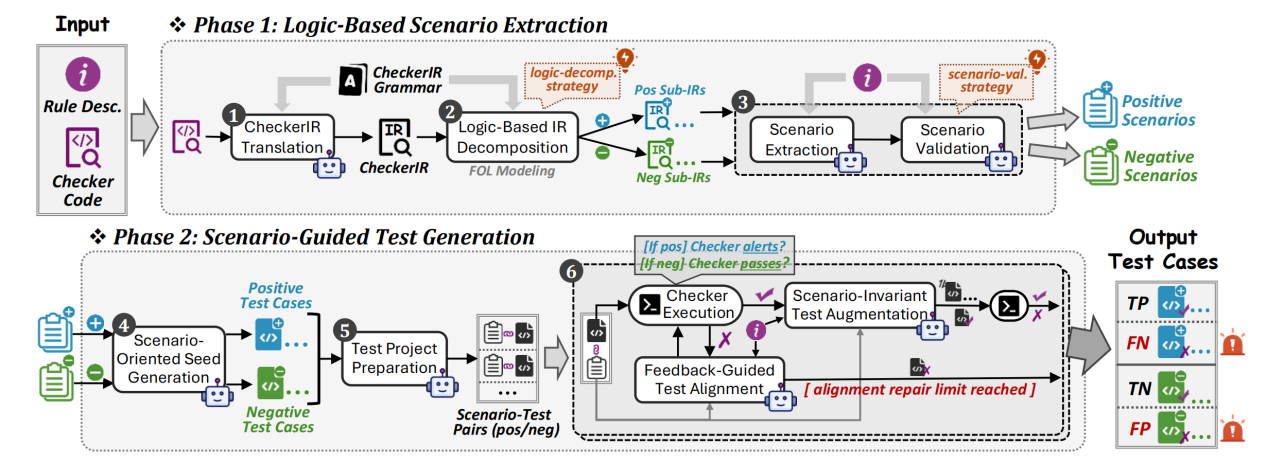
ScenSCT:基于检查场景的双阶段Checker测试方法总览
实验表明,ScenSCT可为每个检查器平均提取9个场景并生成39个测试用例,实现面向代码检查器的多场景全面测试。目前, ScenSCT原生支持六个主流Java代码检查工具(CodeQL、Checkstyle、 Error Prone、PMD、SonarQube和华为内源工具CodeNavi),并且设计上易于扩展至任一其它语言和工具。以CodeQL为例,ScenSCT在CodeQL内置的89条安全相关规则上,发现了 270个经人工核查的潜在误漏报问题,报告准确率为86.4%。
论文链接:https://dl.acm.org/doi/10.1145/3832783.3834381
工具链接:https://github.com/SQUARE-RG/ScenSCT
3. Mind the Gap: Do Widely-Used SAST Tools Really Cover the Language-Specific Top CWEs?
作者:李知霖,聂怡然,齐相龙,燕季薇,严俊
录用会议:ASE 2026
静态代码检查工具对于开发周期早期阶段的漏洞识别发挥着关键作用。然而,静态代码检查工具检测通用缺陷枚举(CWE)实际覆盖范围的能力尚不明确。特别是由于CWE检测排名均为综合性排名,检查工具对特定语言最重要CWE的覆盖程度仍不清楚。
为解决上述问题,研究团队开展了关于静态代码检查工具与特定语言Top CWE之间差距的大规模实证研究。团队利用启发式标记方法,对过去十年间报告的197,016个CVE进行了分析,评估了九款主流静态代码检查工具,以识别覆盖缺口及各工具特有的性能特征。
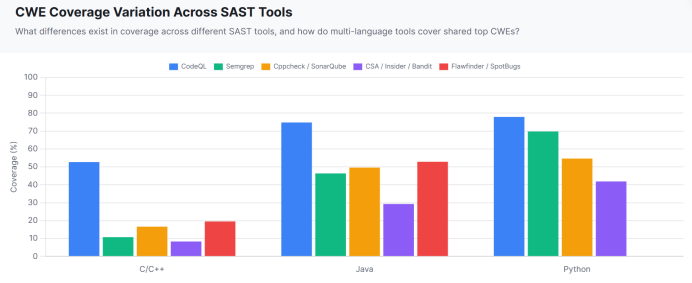
不同语言下静态分析工具对重要CWE的覆盖情况
研究发现,特定语言的高频CWE列表与全局排名的CWE列表存在显著差异,这表明静态代码检查工具在针对不同语言时需关注不同类型的漏洞;现有静态代码检查工具整体对于特定语言高频CWE列表的覆盖存在缺失,尤其C/C++语言方面,凸显了开发更具针对性的代码检查器的必要性;不同静态代码检查工具所覆盖的特定语言的高频CWE集合差异巨大,显示出根据漏洞类型选择并组合工具的重要性;对于多种语言共有的高频CWE,现有多语言分析工具可能仅支持在单一语言中进行检测,这意味着可以通过迁移现有检查器来提升覆盖范围。
这些发现揭示了静态分析在检测特定类型漏洞时面临的基本挑战,既可为改进静态代码检查工具的设计提供启示,也可为从业者选择和组合工具、以更有效地检测特定语言漏洞提供实践指导。
论文链接:https://dl.acm.org/doi/10.1145/3832783.3837435
在线网站:https://language-specific-top-cwe.netlify.app/
以上研究成果为智能化软件质量保障提供了新的理论基础与技术途径。相关方法被应用于华为等企业,展现出良好的推广应用前景。
